

Intel thúc đẩy hạ tầng mở cho kỷ nguyên AI tác nhân (Agentic AI)
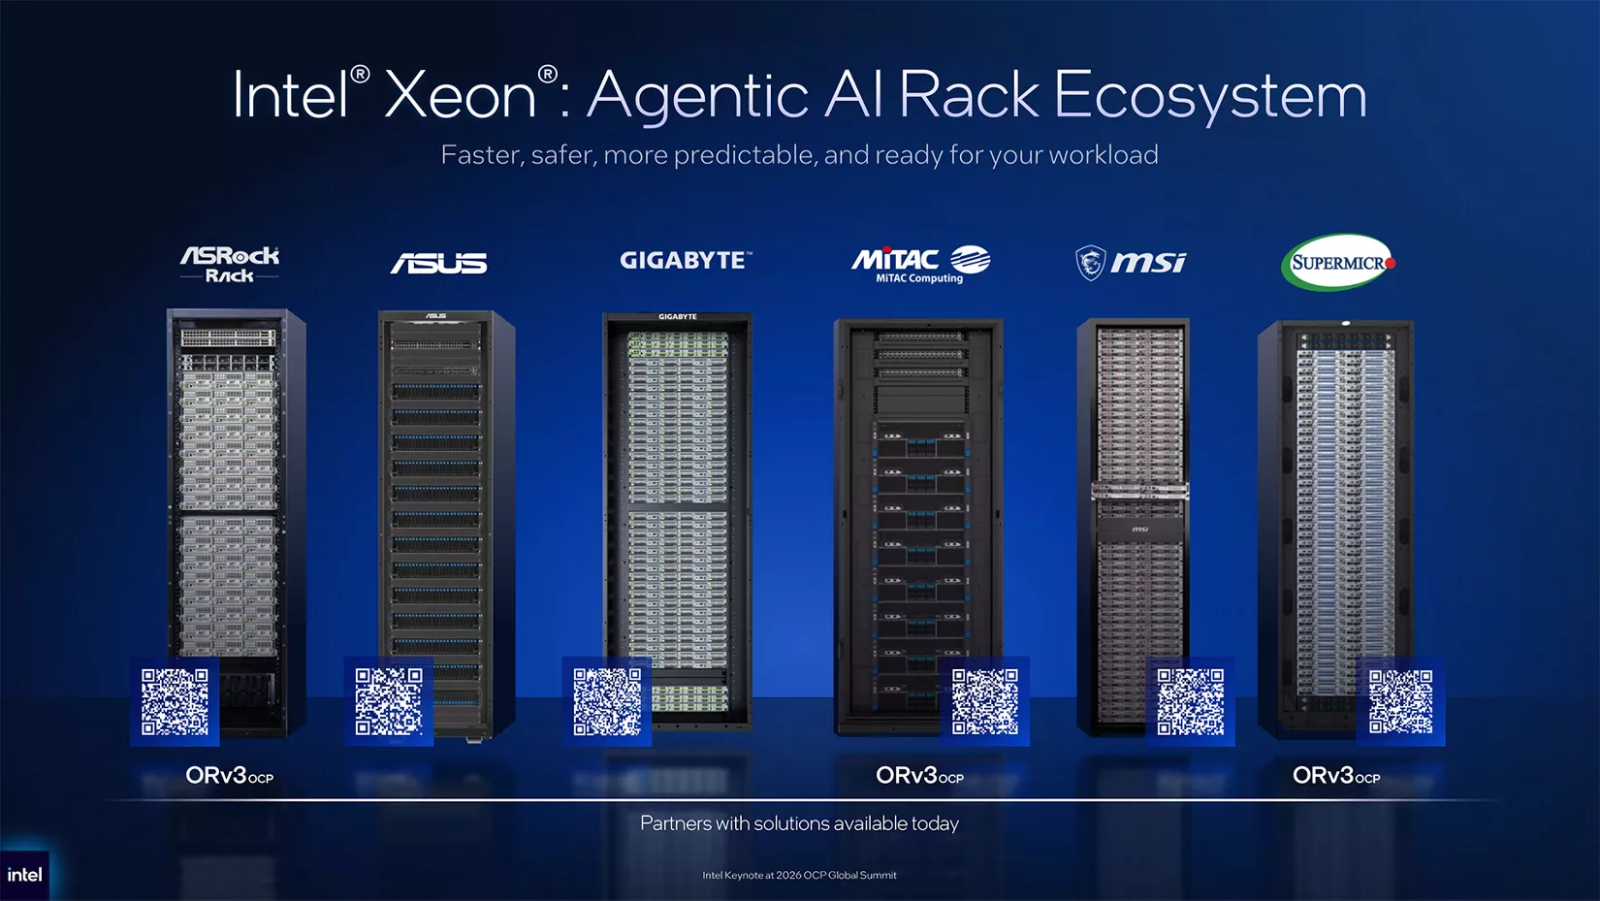
GPU Intel D-series, có tên mã Crescent Island, được thiết kế cho các tác vụ suy luận AI (AI inference) và xây dựng trên kiến trúc Xe3P của Intel. GPU này kết hợp bộ nhớ LPDDR5X dung lượng lên đến 480 GB, băng thông bộ nhớ 1,5 TB/s và năng lực tính toán FP8 đạt 1,3 petaflops, nhằm cải thiện hiệu quả kinh tế của các tác vụ suy luận AI kéo dài và đòi hỏi nhiều bộ nhớ.
Tại Hội nghị thượng đỉnh toàn cầu Open Compute Project (OCP) diễn ra hôm nay, Intel đã chia sẻ thêm các thông tin kỹ thuật mới về GPU Intel D-series, trước đây có tên mã Crescent Island; giới thiệu các thiết kế rack mới dựa trên Intel Xeon; đồng thời nhấn mạnh những đổi mới về phần mềm mở và hệ sinh thái.
Khi các mô hình mở đang làm thay đổi bài toán kinh tế của AI tác nhân, nhu cầu về hạ tầng linh hoạt hơn, tiết kiệm chi phí và năng lượng hơn ngày càng gia tăng. Những bước tiến này thể hiện định hướng của Intel trong phát triển hạ tầng AI mở, không đồng nhất, kết hợp năng lực tính toán đa dụng, các bộ tăng tốc chuyên biệt, phần mềm mở và hệ thống dựa trên tiêu chuẩn chung nhằm tối ưu hiệu năng và hiệu quả trên nhiều loại tác vụ AI.
Vì sao điều này quan trọng?
AI tác nhân đang biến suy luận AI thành một quy trình nhiều bước, bao gồm truy xuất thông tin, suy luận, điều phối, sử dụng công cụ và thực thi tác vụ. Trong quy trình này, CPU x86 đóng vai trò trung tâm.
Mặc dù các mô hình mở mang lại cho doanh nghiệp nhiều lựa chọn hơn, những hạn chế về nguồn điện, nút thắt bộ nhớ và áp lực chi phí khiến việc mở rộng AI ngày càng trở thành một bài toán ở cấp độ toàn hệ thống.
Để đáp ứng các yêu cầu này, doanh nghiệp cần hạ tầng không đồng nhất được tích hợp sẵn, dễ triển khai và quản lý. Dựa trên hệ sinh thái phần mềm x86 đã được thiết lập rộng rãi, Intel kết hợp CPU, GPU và các bộ tăng tốc chuyên dụng thông qua phần mềm mở, có khả năng tương tác với nhau. Cách tiếp cận này giúp phân bổ tài nguyên tính toán phù hợp cho từng tác vụ, cải thiện mức độ sử dụng tài nguyên, hiệu năng và hiệu quả trên toàn bộ quy trình.
“Các mô hình mở đang mở rộng những lựa chọn mà doanh nghiệp có thể sử dụng để triển khai AI. Để khai thác tối đa tiềm năng của chúng, các tổ chức cần hạ tầng có khả năng kết hợp từng loại tác vụ với mô hình trí tuệ phù hợp, tài nguyên tính toán phù hợp và hiệu quả kinh tế phù hợp. Đó chính là điều chúng tôi muốn nói khi sử dụng thông điệp ‘đặt mỗi câu lệnh vào đúng vị trí của nó’.” - Nicolas Dubé, Phó Chủ tịch Tập đoàn, phụ trách Nhóm Hệ thống và Giải pháp Trung tâm dữ liệu, Intel.
Intel Xeon: Nền tảng tính toán cho AI tác nhân
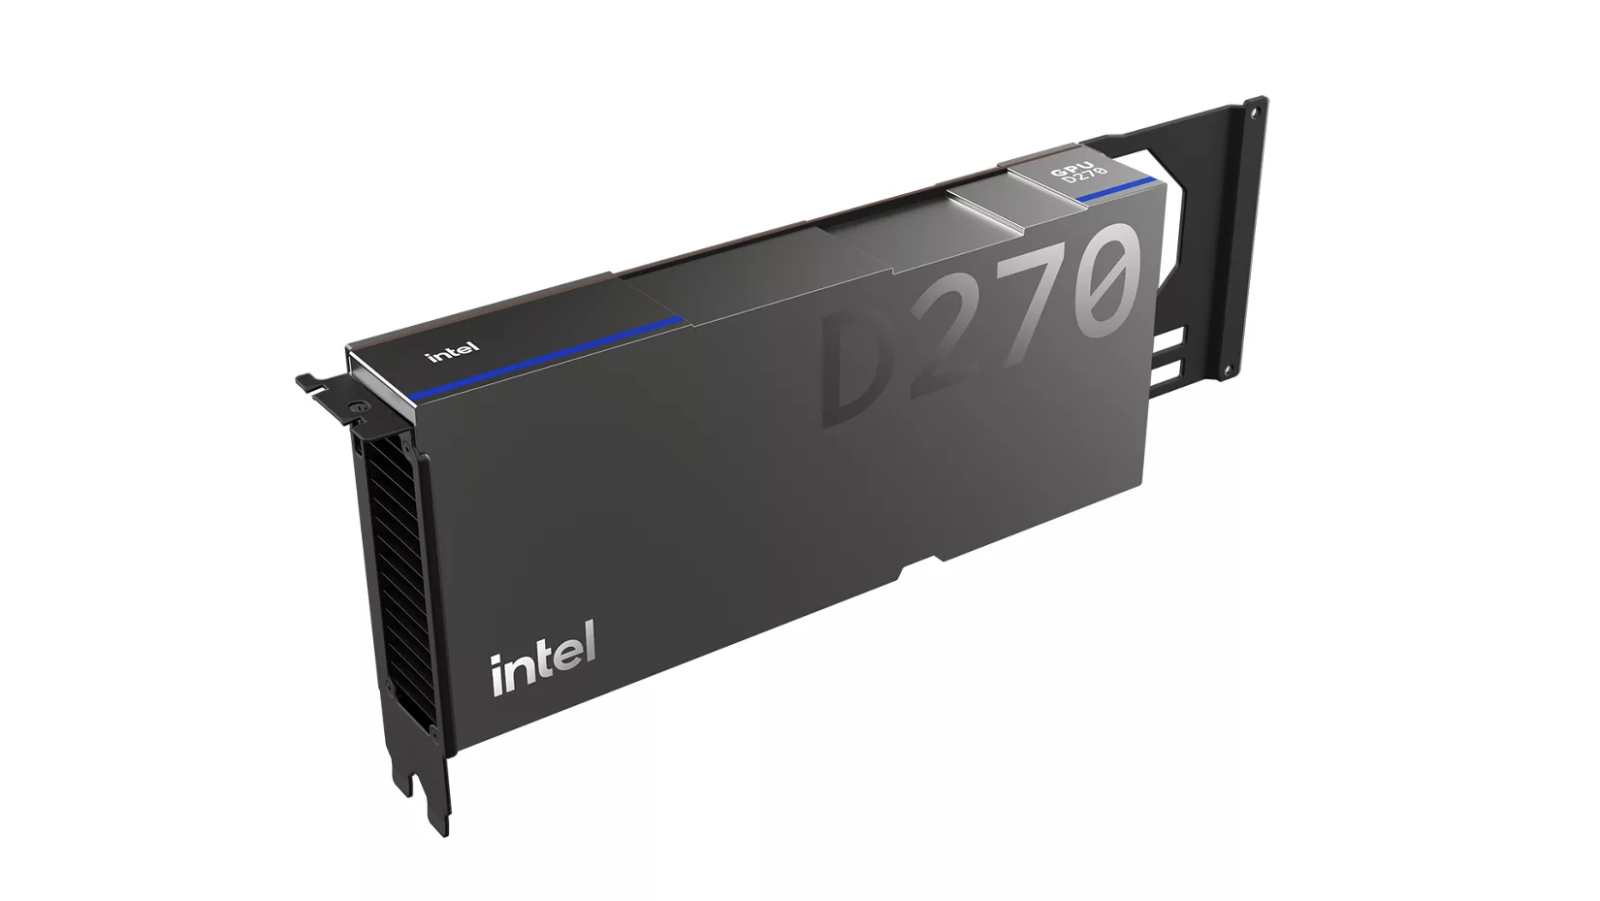
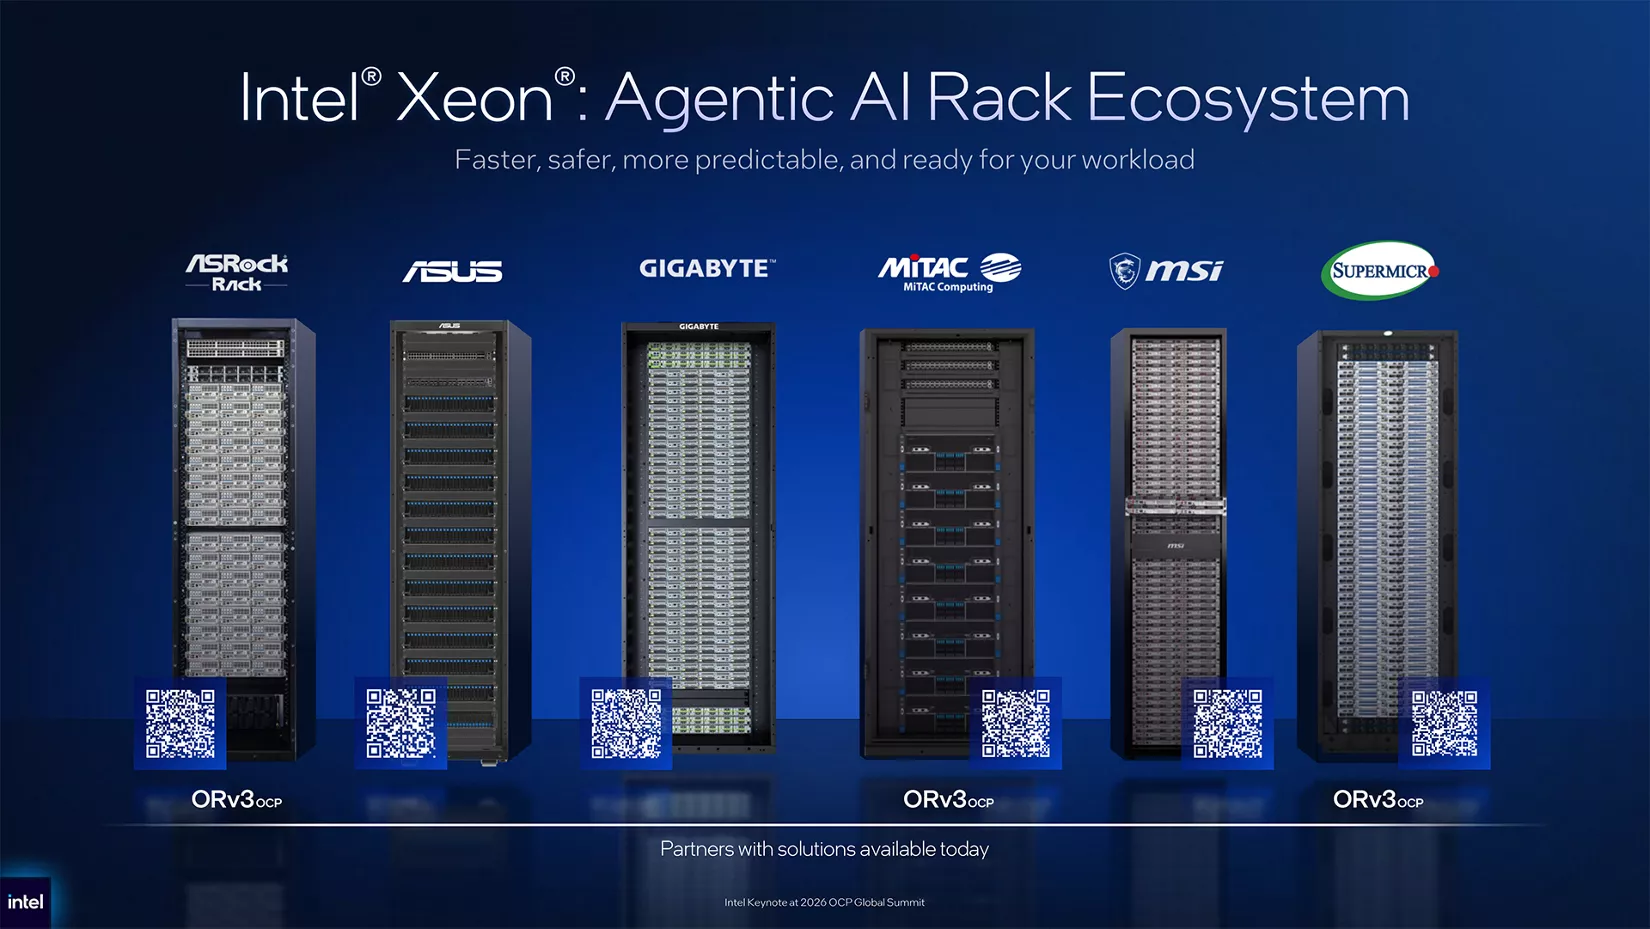
Tại OCP, Intel đã giới thiệu các thiết kế rack mới dựa trên Xeon, được phát triển cùng các đối tác trong hệ sinh thái nhằm đáp ứng nhu cầu tính toán ngày càng tăng của AI tác nhân. Nhiều thiết kế sử dụng tiêu chuẩn Open Rack v3 (ORv3) của Open Compute Project, giúp đơn giản hóa việc triển khai và tích hợp vào hạ tầng trung tâm dữ liệu mở.
Khi các quy trình AI tác nhân trở nên phức tạp hơn, nhu cầu đối với năng lực tính toán đa dụng cũng tăng lên. CPU cần điều phối các tác vụ, xử lý dữ liệu, quản lý hoạt động vào/ra (I/O) và thực thi các công việc để duy trì hiệu quả hoạt động của những bộ tăng tốc.
Để đáp ứng các nhu cầu này, một số cấu hình Xeon 6+ có thể đạt hơn 46.000 lõi CPU trên mỗi rack, với tổng công suất điện của rack là 133,45 kW. Điều này mang lại mật độ tính toán CPU cao hơn, hỗ trợ triển khai AI tác nhân ở quy mô lớn.
Dựa trên hai thập kỷ đổi mới trong kiến trúc rack-scale và hệ sinh thái phần mềm x86 rộng lớn, Xeon cung cấp nền tảng tính toán đa dụng mật độ cao cần thiết để mở rộng AI tác nhân.
Khi hoạt động cùng GPU và các bộ tăng tốc chuyên dụng, Xeon đảm nhiệm việc điều phối khối lượng công việc, thực thi tác vụ và quản lý luồng di chuyển dữ liệu, qua đó duy trì hiệu suất của toàn bộ hệ thống.
Khi hạ tầng AI tiếp tục phát triển, hiệu năng ngày càng được đánh giá dựa trên số lượng tác nhân AI có thể hoạt động đồng thời trong một rack mà vẫn đáp ứng độ trễ mục tiêu, thay vì chỉ dựa vào số lượng lõi xử lý. Xeon góp phần tối đa hóa khối lượng công việc thực tế được hoàn thành bằng cách duy trì luồng dữ liệu, hỗ trợ thực thi công cụ và cung cấp dữ liệu liên tục cho các bộ tăng tốc.
GPU Intel D-series: Được thiết kế chuyên biệt để suy luận hiệu quả ở quy mô lớn
GPU Intel D-series, có tên mã Crescent Island, được thiết kế nhằm cải thiện hiệu quả kinh tế của các tác vụ suy luận AI kéo dài và đòi hỏi nhiều bộ nhớ.
Được xây dựng trên kiến trúc Xe3P mới nhất của Intel, GPU này tích hợp bộ nhớ LPDDR5X lên đến 480 GB, băng thông bộ nhớ 1,5 TB/s và năng lực tính toán FP8 đạt 1,3 petaflops, trong giới hạn công suất 350 W. Sự cân bằng giữa dung lượng bộ nhớ, hiệu năng tính toán và hiệu quả năng lượng phản ánh cách Intel tối ưu hạ tầng cho các tác vụ suy luận trong thực tế.
GPU Intel D-series được thiết kế cho các mô hình ngôn ngữ lớn (LLM), tác vụ xử lý ngữ cảnh dài và dịch vụ suy luận đồng thời. GPU hỗ trợ các mô hình có quy mô lên đến 300 tỷ tham số trên một card và hơn 1.000 tỷ tham số trong hệ thống gồm tám GPU.
Các ứng dụng mục tiêu trải dài từ dịch vụ AI phục vụ nhiều khách hàng dùng chung hạ tầng đến robot và những tác vụ nhạy cảm với độ trễ.
Với thiết kế theo chuẩn PCIe, khả năng làm mát bằng không khí và nền tảng phần mềm Xe dùng chung, GPU Intel D-series hướng đến việc đơn giản hóa triển khai trong các môi trường trung tâm dữ liệu hiện có, đồng thời hỗ trợ khả năng chuyển đổi ứng dụng giữa các nền tảng GPU Intel.
Nhờ đó, khách hàng có thể mở rộng năng lực suy luận mà không cần đầu tư vào hạ tầng rack hoặc hệ thống làm mát chuyên biệt.
“Suy luận đang trở thành khối lượng công việc định hình lĩnh vực AI, và doanh nghiệp cần hạ tầng mang lại hiệu năng phù hợp với mức chi phí hợp lý”, Anil Nanduri, Phó Chủ tịch phụ trách Sản phẩm AI và Chiến lược tiếp thị (GTM), Nhóm Trung tâm dữ liệu Intel, cho biết.
“Với GPU Intel D-series, chúng tôi tập trung biến năng lực suy luận với dung lượng bộ nhớ lớn thành giải pháp thiết thực, dễ triển khai và có thể mở rộng với chi phí hợp lý.”
Để đưa các năng lực này vào môi trường sản xuất thực tế, Intel đang hợp tác với hệ sinh thái rộng lớn gồm các nhà sản xuất thiết bị gốc (OEM), nhà sản xuất thiết kế gốc (ODM), nhà cung cấp dịch vụ đám mây thế hệ mới (neocloud), nhà cung cấp phần mềm độc lập (ISV), nhà cung cấp thiết bị tích hợp và các công ty phát triển AI chuyên biệt.
Những nỗ lực hợp tác này tập trung vào việc xây dựng các nền tảng đã được kiểm chứng, tích hợp phần mềm và cung cấp giải pháp sẵn sàng triển khai, giúp giảm độ phức tạp và rút ngắn thời gian từ giai đoạn đánh giá mô hình đến triển khai trong thực tế.
Hiện Intel đã bắt đầu gửi mẫu sản phẩm cho khách hàng và tiếp tục mở rộng hệ sinh thái phần cứng, phần mềm và mã nguồn mở, mang lại cho doanh nghiệp sự linh hoạt lớn hơn khi triển khai và mở rộng suy luận AI trên cả hạ tầng trung tâm dữ liệu hiện có lẫn các hệ thống mới.
Phần mềm mở cho hạ tầng AI không đồng nhất
Để hạ tầng AI không đồng nhất hoạt động hiệu quả ở quy mô lớn, cần có phần mềm mở giúp kết nối các tài nguyên tính toán, đơn giản hóa triển khai và cho phép nhà phát triển linh hoạt chạy tác vụ trên kiến trúc phù hợp.
Chiến lược phần mềm mở của Intel nhấn mạnh việc tích hợp trực tiếp vào các dự án phần mềm nguồn mở chính thống (upstream), tương thích với những framework AI tiêu chuẩn trong ngành, môi trường thực thi suy luận và nền tảng triển khai trên cả CPU lẫn GPU.
Bằng cách phát triển dựa trên các công cụ mà nhà phát triển đang sử dụng, Intel hướng đến đơn giản hóa quá trình phát triển, tối ưu hiệu năng và đẩy nhanh triển khai thông qua một số năng lực chính:
- Đơn giản hóa triển khai trên các GPU Intel: Được xây dựng trên nền tảng phần mềm Xe dùng chung, GPU Intel D-series hỗ trợ khả năng chuyển đổi phần mềm giữa các nền tảng GPU Intel. Điều này giúp nhà phát triển tái sử dụng ứng dụng hiện có và giảm công sức cần thiết khi triển khai khối lượng công việc trên phần cứng mới.
- Framework mở và phần mềm tối ưu hiệu năng: Intel hỗ trợ các framework AI, công cụ phục vụ mô hình (serving engine) và công cụ phát triển đang được sử dụng rộng rãi trong ngành. Các thành phần này được bổ sung thư viện tối ưu hiệu năng và những lớp phần mềm có thể lập trình nhằm cải thiện thông lượng suy luận. Những framework tương tự cũng hỗ trợ các tác vụ suy luận và ứng dụng AI tác nhân chạy trên bộ xử lý Intel Xeon, cho phép nhà phát triển làm việc trên cả kiến trúc CPU và GPU.
- Hỗ trợ ngay từ ngày đầu (Day 0) cho các mô hình mở mới: Thông qua tích hợp framework vào các dự án nguồn mở chính thống và hỗ trợ đưa mô hình vào sử dụng, Intel đang nỗ lực hỗ trợ các mô hình mở mới ngay khi chúng được phát hành trên GPU Intel D-series và bộ xử lý Xeon. Những nỗ lực gần đây bao gồm hỗ trợ Day 0 cho Muse Glimmer của Meta, giúp nhà phát triển nhanh chóng đánh giá và triển khai các tác vụ AI tác nhân mới.
- Phát triển cho ứng dụng AI và tác nhân trong thực tế: Nền tảng phần mềm của Intel hỗ trợ nhiều loại khối lượng công việc, từ tạo token với thông lượng cao đến các tác nhân lập trình và quy trình doanh nghiệp phức tạp. Bộ công cụ Intel AI for Enterprise Agent Toolkit hiện được tối ưu hóa và có thể triển khai trên bộ xử lý Xeon, cung cấp năng lực điều phối cho các ứng dụng AI tác nhân trong môi trường sản xuất. Kiến trúc dựa trên các nhà cung cấp thành phần của bộ công cụ được thiết kế để mở rộng sang GPU Intel, tạo nền tảng linh hoạt cho các quy trình đa phương thức và giúp doanh nghiệp mở rộng trên nhiều tài nguyên tính toán không đồng nhất.
Hạ tầng mở cho AI không đồng nhất
Intel tiếp tục thúc đẩy hạ tầng mở thông qua hoạt động hợp tác với Open Compute Project. Kể từ năm 2011, công ty đã có 116 đóng góp cho dự án này.
Trong năm nay, Intel giới thiệu đóng góp của mình cho nhóm công tác Open Adapter Card. Được phát triển cùng các đối tác trong ngành, sáng kiến này hướng đến xác định một chuẩn kích thước và hình dạng thống nhất cho card tăng tốc dạng mô-đun lắp trong phân hệ rack (sub-rack).
Nỗ lực này nhằm cải thiện khả năng tương thích về cơ khí, điện và quản lý giữa các thiết kế hệ thống khác nhau, giúp các nhà xây dựng hệ thống và nhà cung cấp dịch vụ đám mây có phương thức nhất quán hơn để tích hợp bộ tăng tốc vào hạ tầng mở.
Đối với khách hàng, giá trị của cách tiếp cận này nằm ở khả năng phát triển hệ thống AI mà không phải xây dựng lại từ đầu. Bằng cách tận dụng các khoản đầu tư hiện có và bổ sung công nghệ tính toán mới khi yêu cầu khối lượng công việc thay đổi, doanh nghiệp có thể mở rộng năng lực suy luận hiệu quả hơn, kiểm soát chi phí và duy trì quyền lựa chọn hướng phát triển hạ tầng.
Nhấn mạnh định hướng này, Kevork Kechichian, Phó Chủ tịch Điều hành kiêm Tổng Giám đốc Nhóm Trung tâm dữ liệu Intel, cho biết:
“AI tác nhân đang thay đổi những gì khách hàng cần từ trung tâm dữ liệu. Thành công sẽ không phụ thuộc vào một thành phần đơn lẻ, mà vào hạ tầng mở, không đồng nhất, kết hợp Xeon, các bộ tăng tốc chuyên dụng và phần mềm có khả năng tương tác với nhau. Intel đang giúp khách hàng phát huy giá trị từ những khoản đầu tư hiện có, đồng thời xây dựng nền tảng linh hoạt để mở rộng các khối lượng công việc AI mới một cách hiệu quả.”
Người tham dự có thể ghé thăm Intel tại gian hàng B32 và lắng nghe các lãnh đạo Intel chia sẻ, trong đó có bài phát biểu chính của Nic Dubé với chủ đề “Put Every Prompt in Its Place” vào lúc 10:30 sáng ngày 13/10 theo giờ Thái Bình Dương (PT).
Chia sẻ bài viết


Bình luận
( 0 bình luận )Bình luận của bạn
Tin tức liên quan