

AMD phát triển MEXT: Tận dụng bộ nhớ Flash để giảm tới 75% nhu cầu DRAM trong máy chủ
Trong bối cảnh giá DRAM tăng cao và nguồn cung bộ nhớ tiếp tục chịu áp lực, AMD đang tìm kiếm một hướng tiếp cận mới nhằm tối ưu dung lượng bộ nhớ trong các trung tâm dữ liệu. Thay vì tiếp tục mở rộng DRAM bằng cách bổ sung thêm các mô-đun vật lý, hãng đang phát triển MEXT Predictive Memory Software, giải pháp phần mềm ứng dụng AI để kết hợp DRAM với bộ nhớ Flash, hướng tới giảm chi phí đầu tư mà vẫn duy trì hiệu năng cho các ứng dụng doanh nghiệp.
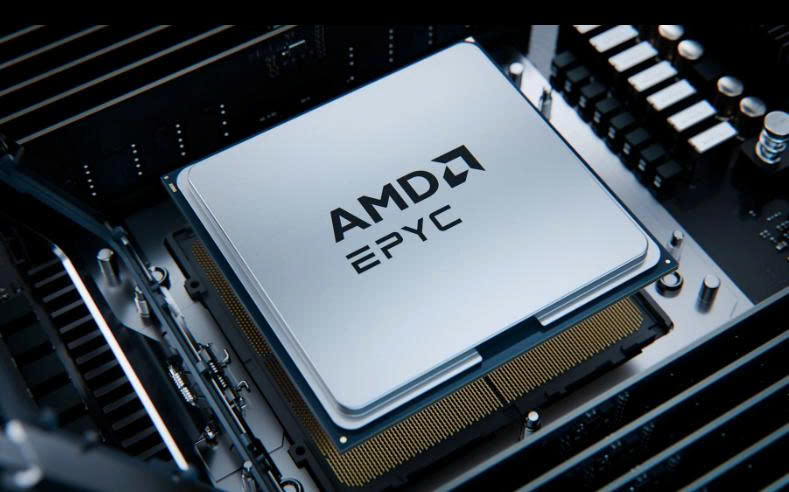
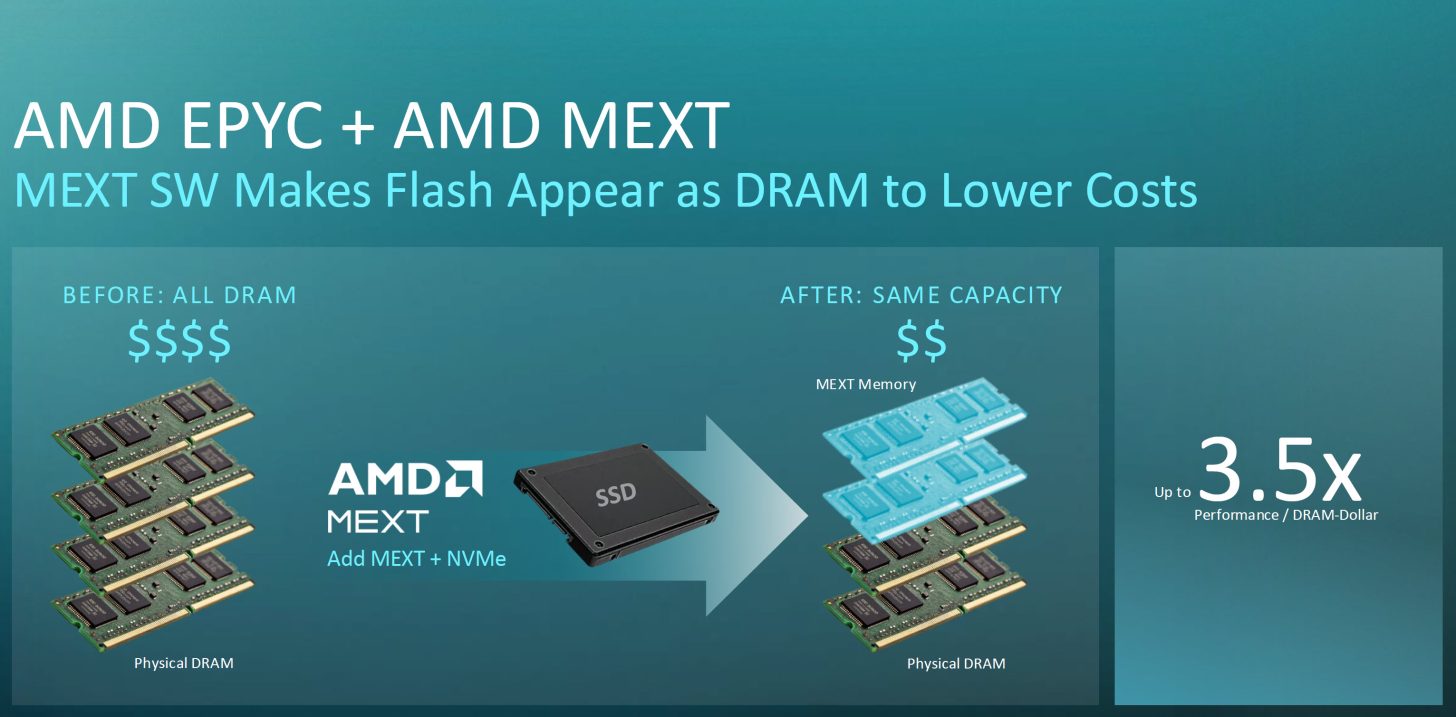
Theo các thông tin được công bố trong tháng 11/2026, giải pháp MEXT có thể giúp giảm 20% đến 75% nhu cầu DRAM trên các hệ thống máy chủ AMD EPYC, tùy thuộc vào đặc điểm workload. Đây là một hướng tiếp cận đáng chú ý khi chi phí bộ nhớ đang trở thành yếu tố quan trọng trong kế hoạch mở rộng hạ tầng AI và điện toán doanh nghiệp.
AMD MEXT: Tối ưu DRAM bằng bộ nhớ Flash và AI
Tháng 6/2026, AMD thông báo hoàn tất thương vụ mua lại MEXT, doanh nghiệp phát triển công nghệ tối ưu bộ nhớ dựa trên AI. Mục tiêu của thương vụ là bổ sung công nghệ giúp mở rộng dung lượng bộ nhớ khả dụng, cải thiện hiệu năng trên chi phí đầu tư và giải quyết những hạn chế về bộ nhớ trong hạ tầng điện toán hiện đại.
Theo AMD, MEXT sử dụng công nghệ dự đoán bằng AI để khai thác bộ nhớ Flash dung lượng lớn, chi phí thấp hơn DRAM, tạo thêm một tầng bộ nhớ cho hệ thống máy chủ.
Cơ chế hoạt động tập trung vào việc phân loại dữ liệu theo tần suất truy cập. Những trang bộ nhớ ít được sử dụng, còn gọi là dữ liệu lạnh (cold memory pages), sẽ được chuyển từ DRAM sang ổ SSD Flash. Trong khi đó, bộ máy AI của MEXT liên tục phân tích và dự đoán dữ liệu nào có khả năng được ứng dụng truy cập tiếp theo, sau đó chủ động đưa dữ liệu trở lại DRAM trước khi phát sinh yêu cầu.
Cách tiếp cận này giúp hệ thống tận dụng dung lượng Flash để mở rộng bộ nhớ khả dụng, đồng thời ưu tiên DRAM cho những dữ liệu cần tốc độ truy cập cao. MEXT hướng tới việc duy trì hiệu năng ứng dụng mà không cần thay đổi đáng kể kiến trúc phần mềm hiện có.
Giảm nhu cầu DRAM và tối ưu chi phí máy chủ
Một trong những vấn đề phổ biến tại các trung tâm dữ liệu là tình trạng cấp phát bộ nhớ vượt quá nhu cầu sử dụng thực tế. Doanh nghiệp thường phải trang bị thêm DRAM để dự phòng cho các giai đoạn tải cao, tránh tình trạng thiếu bộ nhớ gây suy giảm hiệu năng.
Tuy nhiên, không phải toàn bộ dung lượng DRAM được cấp phát đều được sử dụng liên tục. Một phần bộ nhớ có thể chứa dữ liệu ít được truy cập hoặc không còn nằm trên đường xử lý chính của ứng dụng.
MEXT hướng đến giải quyết vấn đề này bằng cách đưa dữ liệu ít hoạt động sang Flash, qua đó giảm lượng DRAM cần trang bị cho mỗi máy chủ.
Theo các số liệu được Wccftech dẫn lại, AMD cho biết MEXT có thể giúp giảm nhu cầu DRAM từ 20% đến 75% tùy cấu hình và workload. Với một số hệ thống có tỷ lệ sử dụng bộ nhớ thấp, việc kết hợp DRAM và Flash có thể mở rộng đáng kể dung lượng bộ nhớ khả dụng mà không phải đầu tư tương ứng vào DRAM vật lý.
AMD cũng đưa ra các kết quả triển khai nội bộ đáng chú ý. Theo Wccftech, đợt triển khai ban đầu trên 145 máy chủ được kỳ vọng giúp AMD tránh khoản chi khoảng 4,9 triệu USD cho việc mua thêm DRAM. Chi phí mở rộng bộ nhớ được báo cáo giảm 83% so với phương án nâng cấp tương đương chỉ sử dụng DRAM.
AMD dự kiến mở rộng quy mô triển khai lên 2.000 máy chủ vào năm 2027. Những con số này cho thấy MEXT không chỉ hướng đến cải thiện hiệu quả sử dụng bộ nhớ mà còn có tiềm năng tác động trực tiếp đến chi phí đầu tư hạ tầng.
MEXT hướng đến các workload AI và đa tác tử
Bên cạnh môi trường máy chủ doanh nghiệp truyền thống, AMD cũng nhấn mạnh tiềm năng của MEXT đối với các ứng dụng AI, đặc biệt là những workload sử dụng nhiều bộ nhớ.
Trong các hệ thống Agentic AI, nhiều AI agent có thể hoạt động đồng thời, thực hiện các tác vụ như truy xuất dữ liệu, gọi công cụ, tương tác với cơ sở dữ liệu và duy trì ngữ cảnh xử lý. Những hoạt động này làm gia tăng nhu cầu bộ nhớ và tạo thêm áp lực lên khả năng phân bổ tài nguyên của máy chủ.
Theo các kết quả được AMD đề cập và Wccftech dẫn lại, cấu hình kết hợp 50% DRAM và 50% Flash thông qua MEXT có thể cải thiện hiệu năng trên mỗi USD đầu tư khoảng 90% trong một số workflow có năm AI agent hoạt động đồng thời, và khoảng 70% đối với các ứng dụng AI có nhu cầu bộ nhớ cao.
Đây là các kết quả được báo cáo trong những kịch bản cụ thể, không nên hiểu là mức cải thiện áp dụng đồng đều cho mọi workload AI. Hiệu quả thực tế sẽ phụ thuộc vào đặc điểm truy cập bộ nhớ, tỷ lệ dữ liệu lạnh và yêu cầu độ trễ của từng ứng dụng.
AMD hợp tác với HPE để đưa MEXT đến doanh nghiệp
AMD đang từng bước mở rộng khả năng thương mại hóa MEXT thay vì chỉ giới hạn công nghệ trong hệ thống nội bộ.
Theo Wccftech, AMD hợp tác với Hewlett Packard Enterprise (HPE) để đưa giải pháp này đến khách hàng doanh nghiệp. Giai đoạn đầu tập trung vào các hệ thống máy chủ tương thích với MEXT, có số lượng lõi CPU phù hợp và khả năng mở rộng dung lượng lưu trữ NVMe.
Định hướng này cho thấy AMD muốn kết hợp năng lực xử lý của EPYC với công nghệ quản lý bộ nhớ và lưu trữ để tạo ra các cấu hình máy chủ có hiệu quả đầu tư tốt hơn, đặc biệt trong bối cảnh doanh nghiệp phải cân đối giữa nhu cầu mở rộng năng lực tính toán và chi phí DRAM.
NVIDIA cũng khai thác Flash để mở rộng dung lượng KV Cache
AMD không phải nhà sản xuất duy nhất quan tâm đến việc sử dụng Flash nhằm giải quyết các giới hạn về bộ nhớ trong hạ tầng AI. NVIDIA cũng đang phát triển một hướng tiếp cận liên quan thông qua nền tảng Context Memory Storage (CMX), tập trung vào bài toán lưu trữ và chia sẻ KV Cache trong quá trình suy luận AI.
KV Cache lưu giữ các kết quả tính toán trung gian của những token đã được xử lý, giúp mô hình AI không phải tính toán lại toàn bộ ngữ cảnh trong các bước tiếp theo. Khi các mô hình hỗ trợ cửa sổ ngữ cảnh dài hơn và nhiều AI agent hoạt động đồng thời, dung lượng KV Cache tăng lên đáng kể, tạo áp lực lên bộ nhớ HBM của GPU.
Với CMX, NVIDIA xây dựng một tầng lưu trữ Flash chuyên biệt nằm trong hệ thống phân cấp bộ nhớ dành cho AI inference. Nền tảng sử dụng bộ xử lý NVIDIA BlueField-4, kết hợp với mạng Spectrum-X Ethernet và phần mềm DOCA Memos để quản lý, chia sẻ và truy xuất KV Cache giữa các nút trong cụm AI.
Thay vì yêu cầu toàn bộ KV Cache phải nằm trong HBM có dung lượng hạn chế, CMX cho phép chuyển những dữ liệu ngữ cảnh phù hợp sang tầng Flash dùng chung và đưa chúng trở lại bộ nhớ tốc độ cao khi cần thiết. Cách tổ chức này giúp mở rộng dung lượng ngữ cảnh khả dụng, giảm việc tính toán lại dữ liệu và cải thiện hiệu quả sử dụng GPU.
Theo NVIDIA, CMX được thiết kế để hỗ trợ các workload suy luận có ngữ cảnh dài, nhiều lượt tương tác và nhiều AI agent. Hãng công bố nền tảng có thể đạt hiệu năng xử lý token cao hơn tới 5 lần và hiệu quả sử dụng năng lượng cao hơn tới 5 lần so với các phương pháp lưu trữ truyền thống trong những điều kiện được công bố.
Mặc dù cùng khai thác Flash để giảm áp lực lên bộ nhớ tốc độ cao, AMD MEXT và NVIDIA CMX giải quyết hai bài toán khác nhau. MEXT tập trung tối ưu việc sử dụng DRAM trong máy chủ bằng cơ chế phân tầng bộ nhớ có AI dự đoán, trong khi CMX xây dựng một tầng lưu trữ ngữ cảnh chuyên biệt cho KV Cache trong hạ tầng AI inference.
Tối ưu bộ nhớ trở thành một phần quan trọng của chiến lược hạ tầng AI
Khi quy mô trung tâm dữ liệu và các workload AI ngày càng mở rộng, việc bổ sung CPU và GPU không còn là yếu tố duy nhất quyết định hiệu quả đầu tư. Khả năng khai thác DRAM, Flash, HBM và hệ thống lưu trữ cũng ảnh hưởng trực tiếp đến hiệu năng, chi phí vận hành và khả năng mở rộng của toàn bộ hạ tầng.
Các hướng tiếp cận như AMD MEXT và NVIDIA CMX cho thấy xu hướng phân tầng bộ nhớ đang được chú trọng hơn. Thay vì sử dụng một loại bộ nhớ tốc độ cao cho mọi dữ liệu, các nhà cung cấp đang tìm cách phân bổ dữ liệu theo mức độ truy cập, yêu cầu độ trễ và đặc điểm workload.
Đối với doanh nghiệp đầu tư máy chủ và trung tâm dữ liệu, đây có thể là một hướng đi đáng quan tâm để tối ưu cấu hình DRAM, khai thác hiệu quả hệ thống NVMe SSD và kiểm soát tổng chi phí sở hữu (TCO) khi mở rộng hạ tầng AI.
Chia sẻ bài viết


Bình luận
( 0 bình luận )Bình luận của bạn
Tin tức liên quan